在 SGLang-Omni 上部署原生流式 48 kHz 的 MOSS-TTS Local Transformer v1.5 语音服务
MOSI、OpenMOSS团队与 SGLang-Omni Team·2026年6月
我们正在发布 MOSS-TTS-Local-Transformer-v1.5 在 SGLang-Omni 上的端到端 serving 支持。这项工作由 SGLang-Omni Team 和 OpenMOSS团队 共同完成。
MOSS-TTS-Local-Transformer-v1.5 是一个开放的 TTS 模型,支持 48 kHz 立体声、zero-shot voice cloning、长文本合成、多语言生成、时长控制和 native streaming。用 demo script 调起这个模型并不难,真正难的是把它服务好:一个请求会跨过参考音频编码、Qwen3-4B 自回归 backbone、frame-local 的 12-codebook sampling loop,以及有状态的 codec decoder。
SGLang-Omni 没有把 MOSS-TTS-Local-Transformer-v1.5 硬塞进单个 LLM decode loop,而是把它作为三阶段 pipeline 来服务。本文的工作主要围绕这层映射:阶段边界在哪里,哪些部分需要模型专用 hook,以及模型在负载下运行后暴露出了哪些瓶颈。
MOSS-TTS-Local-Transformer-v1.5 模型
MOSS-TTS-Local-Transformer-v1.5 是 MOSS-TTS v1.5 家族的第二个旗舰模型。它沿用了 Audio Tokenizer + LLM autoregressive 路线,使用更重的 audio codec,以及 Global Transformer + Local Transformer 的生成路径。
它支持 direct TTS、continuation、zero-shot voice cloning、时长控制、显式 pause markup 例如 [pause 3.2s],以及最长 10 分钟的 long-form generation。模型覆盖 31 种主要语言,训练数据约为 400 万小时多语言语音。

MOSS-TTS-Local-Transformer-v1.5 model architecture
在音频边界,MOSS 使用 MOSS-Audio-Tokenizer-v2,这是一个 encoder 和 decoder 合计约 2B 参数的 neural audio tokenizer。它以 12.5 Hz 运行,支持 0.125 kbps 到 4 kbps 的可变比特率压缩,重建 48 kHz 立体声音频,并通过 residual vector quantization (RVQ) 表示语音。
生成核心使用 Qwen3-4B backbone。global transformer 按 frame 推进序列。对于每一帧,一层 local transformer 先输出 stop/continue 决策,然后按顺序采样 12 个 RVQ codebook,并在采样下一个 codebook 前把当前采样结果反馈回来。
serving 可见的 token layout 是 [T, 13]:一个 text/control channel 和 12 个 audio codebook channel。text 位置在 channel 0 放 text token,其余 channel 放 audio padding。audio 位置在 channel 0 放 slot/control token,并在每个 audio codebook channel 放一个 RVQ code。这是 MOSS 第一次不再像普通 next-token model 的地方:每个生成的 frame 是一行,而不是一个标量 token。
在公开 model-level evaluation set 上:
| Benchmark | WER(越低越好) | SIM(越高越好) |
|---|---|---|
| Seed-TTS-Eval | 5.10% | 69.23% |
| CV3-Eval | 7.48% | 61.59% |
| MiniMax Multilingual | 6.37% | 75.31% |
| X Voice | 20.48% | 63.00% |
这些是 offline model metrics。后面的 serving benchmark 使用不同的 evaluation pipeline,应当按端到端系统测量来解读。
MOSS-TTS-Local-Transformer-v1.5 在阿里云 PPU-ZW810 集群上以千卡规模训练。本文聚焦 serving 侧。
为什么 MOSS 需要多阶段 serving runtime
标准 LLM serving engine 围绕一个重复执行的 model loop 构建。MOSS 的一个请求中包含三类不同的工作:
- 预处理和参考编码。 文本会被 tokenize,参考音频会被加载,参考 waveform 会被编码成 RVQ codes。
- Autoregressive TTS engine。 Qwen3 backbone 和 local transformer 生成
[1, 13]的 frame rows。 - Streaming vocoder。 生成的 RVQ rows 会被有状态的 MOSS codec decoder 解码为 waveform chunks。
每个阶段的瓶颈都不同。参考编码运行大型 neural codec encoder。AR generation 把普通 backbone decode 和一个很小但严格串行的 local codebook loop 混在一起。vocoder 是有状态 decoder,必须跨 chunks 保留 streaming state。系统需要同时管理这三部分,并避免某个阶段的 batching 或内存行为破坏其他阶段。
用 SGLang-Omni 服务 MOSS
SGLang-Omni 将 MOSS-TTS Local Transformer v1.5 作为三阶段 pipeline 来服务:
preprocessing -> tts_engine -> vocoder
preprocessing 阶段解析 OpenAI-compatible request,准备 multi-channel prompt,并为 voice cloning 编码参考音频。tts_engine 阶段运行在 OmniScheduler 上,因此 MOSS 可以复用 SGLang 的 request batching 和 KV-cache 机制,同时携带模型专用的 [T, 13] rows。vocoder 阶段以 stream 方式消费生成的 rows,并从一个持久化的 codec streaming session 返回 audio chunks。
复用的部分是 runtime 形态:stage lifecycle、scheduler interface、inter-stage routing、streaming outputs、process placement,以及 stage-level resource accounting。MOSS 专用的部分更小也更显式:如何构造 multi-channel prompt,如何运行 frame-local codebook loop,以及如何把 MOSS codec 接成 streaming decoder。下一节只聚焦这些 MOSS 专用瓶颈和优化。
MOSS 端到端优化
pipeline 功能完成后,我们优化了 profiling 中反复出现重复工作或 launch overhead 的阶段。
| Area | Change | Main Benefit | Source |
|---|---|---|---|
| Model serving baseline | MOSS Local model、pipeline 和 API 支持 | 建立三阶段 serving 路径 | PR #728 |
| Reference encoding | batched encoding、content-addressed LRU cache 和 single-flight deduplication | 避免为复用 speaker 重复运行 codec encoder | PR #748PR #778PR #788 |
| AR engine | decode-state pool、frame CUDA Graph support 和 GPU-native row hash | 让 decode state 保持稳定 GPU 地址,并移除每帧 host hashing | PR #745 |
| AR engine | frame launch-state pooling 和 async decode plumbing | 降低 launch 准备开销,并修复 decode-step ownership 问题 | PR #759PR #758 |
| AR engine | compiled seeded sampler | 融合 hot sampling path,同时保持 deterministic per-request sampling | PR #773 |
| Vocoder | stateful streaming session、stream slots 和 coalesced chunk scheduling | 用 request isolation 支持 frame-level audio streaming | PR #753 |
| Vocoder | stateful vocoder CUDA Graph | 加速短 streaming decode steps | PR #798 |
| Cross-stage | explicit colocated memory budgeting | 防止 codec 和 AR 的内存压力互相干扰 | PR #810 |
Source 列为 SGLang-Omni GitHub PR 编号,点击可查看详情。
参考音频编码
voice cloning 经常在很多 prompts 之间复用同一批 speakers。在 MOSS 中这一点很重要,因为参考编码要在 AR generation 开始前运行大型 codec encoder。
Content-addressed reference audio cache
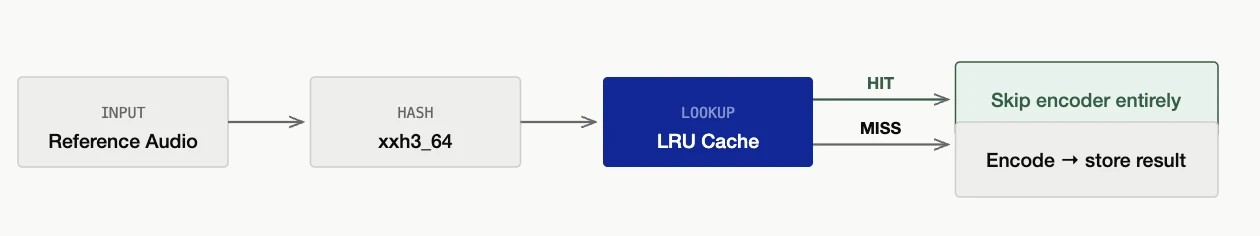
SGLang-Omni 将 batched reference encoding 与 content-addressed LRU cache 结合。重复的 reference 由音频内容而不是路径作为 key,因此复制或重命名后的文件仍然可以复用同一个 encoded RVQ result。single-flight 路径会合并同一个 speaker 的并发 miss,避免冷缓存突发时启动重复的 codec encode。
在 SeedTTS English evaluation 中,在 2x H100、concurrency 16 下,将 reference cache capacity 从 256 提升到 1024 entries,使 throughput 提升 32.0%,mean latency 降低 24.3%。内存成本很小,因为 encoded code tensors 很紧凑;更大的 cache 主要是避免 active speaker working set 被驱逐。
AR Engine
MOSS AR engine 有两层计算:Qwen3 backbone 和 local transformer frame-decode loop。SGLang-Omni 用 CUDA Graphs 捕获两者,但保持分离,因为它们的结构和 ownership 不同。

Eager vs. CUDA Graph execution
backbone graph 使用 SGLang 标准的 CUDA Graph path 进行 causal LM decode。MOSS 专用的 frame graph 捕获一个完整 frame 的 local transformer micro-loop:stop/continue sampling、12 个顺序 codebook projections、codebook feedback,以及为下一帧组装 feedback embedding。它从这个很小但高度串行的 loop 中移除了 launch overhead。
为了让 graph replay 成为可能,MOSS 将 per-request decode state 保存在持久化的 GPU-side pool 中。feedback embeddings、sampling parameters、seeds、counters 和 audio history 跨 frame 保持稳定地址。SGLang-Omni 还把 generated-row radix hash 移到 GPU,避免每帧 CPU hash 和 D2H synchronization。
每帧的 13 次 sampling operation 使用 seeded GPU sampler。我们只 compile 这个 sampling path,不 compile backbone 或 local transformer。在 SeedTTS English、concurrency 16 下,这个窄范围优化在不改变更大模型执行路径的情况下,使 throughput 提升 12.3%,mean latency 降低 11.1%,mean RTF 降低 10.5%。
Streaming Vocoder
vocoder 阶段把生成的 RVQ frames 转换为 audio chunks。由于 MOSS-Audio-Tokenizer-v2 支持 stateful streaming decode,SGLang-Omni 在 vocoder executor 内保留一个持久化的 codec streaming session。
scheduler 管理 stream slots、offline fallback slot、chunk thresholds 和 coalesced decode steps。首个 chunk 可以使用较小 threshold 来降低 time to first audio,后续 chunks 则使用更大的窗口来提高 throughput。当多个请求都有足够的 pending frames 时,scheduler 会把它们合并到一次 codec call 中解码。
短 streaming chunks 对 launch 很敏感,因此 SGLang-Omni 用 CUDA Graphs 捕获常见的 vocoder frame counts。实现中 codec state buffers 保持稳定地址并原地更新,使 graph 可以跨 streaming steps replay。
短 streaming chunks 的加速最明显:
| Frames per Step | Eager | CUDA Graph | Speedup |
|---|---|---|---|
| 4 | 66.3 ms | 30.1 ms | 2.20x |
| 5 | 65.8 ms | 30.7 ms | 2.14x |
| 8 | 65.6 ms | 34.0 ms | 1.93x |
| 13 | 65.4 ms | 40.4 ms | 1.62x |
| 25 | 74.8 ms | 58.3 ms | 1.28x |
| 100 | 222.9 ms | 215.3 ms | 1.04x |
当 frame count 没有被 capture,或内存紧张时,graph path 会 fallback 到 eager decode。streaming/non-streaming consistency checks 覆盖了这条路径。
内存预算
在默认 MOSS Local config 中,preprocessing、AR generation 和 vocoder execution 可以 colocate 到一张 GPU 上。这种紧凑布局很方便,但 AR engine 和 codec runtime 的 allocation pattern 不同。因此 SGLang-Omni 给 AR engine 一个显式的 colocated memory contract,并为 codec runtime allocations 和 streaming state 预留 headroom。
在单卡 colocated 配置、concurrency 8 下,显式 codec memory budgeting 使 throughput 提升 8.9%,mean RTF 降低 8.4%。更重要的是,它让 memory pressure 下的部署行为可预测。
性能
我们在包含 1088 个 samples 的 SeedTTS English set 上评估优化后的 serving path。下面结果来自启用 vocoder CUDA Graph 后的完整 CI evaluation,使用 2x GPU 和 client concurrency 16。ASR scoring 使用 Qwen3-ASR-1.7B,speaker similarity 使用 WavLM-Large finetune。
| Mode | Completed / Failed | Throughput | Audio Throughput | Mean Latency | Mean RTF | WER |
|---|---|---|---|---|---|---|
| Non-streaming | 1088 / 0 | 5.976 req/s | 26.303 audio s/s | 2.669 s | 0.644 | 1.75% |
| Streaming | 1088 / 0 | 2.909 req/s | 12.804 audio s/s | 5.474 s | 1.322 | 2.14% |
non-streaming 达到 5.976 req/s,mean RTF 为 0.644。streaming 会发出增量 audio chunks;在 concurrency 16 下,平均 inter-chunk interval 是 0.109 s,每个请求平均发出 8.82 个 chunks。streaming throughput 更低是预期内的:vocoder 会用更小 chunks 更频繁地运行,并与 AR engine 共享 GPU 时间。
两个模式的质量数字保持接近:同一个 CI run 中,non-streaming WER 是 1.75%,streaming WER 是 2.14%。streaming/non-streaming artifact consistency checks 也通过。
不要把单项优化的测量结果相加成一个 headline number,因为它们是在不同硬件和 concurrency 设置下采集的。它们更适合用作 MOSS 耗时分布图:reference caching 移除冗余 encoder work,frame CUDA Graphs 移除 local-loop launch overhead,sampler compilation 优化 hot sampling path,vocoder CUDA Graphs 加速短 streaming chunks,memory budgeting 稳定 colocated deployment。
自己试用
SGLang-Omni MOSS-TTS-Local cookbook 提供完整 setup、API options 和 streaming examples。最小路径如下:
安装并启动服务
docker pull lmsysorg/sglang-omni:dev
docker run -it --gpus all --shm-size 32g --ipc host --network host --privileged \
 lmsysorg/sglang-omni:dev /bin/zsh

git clone git@github.com:sgl-project/sglang-omni.git
cd sglang-omni
uv venv .venv -p 3.12
source .venv/bin/activate
uv pip install -v -e .

hf download OpenMOSS-Team/MOSS-TTS-Local-Transformer-v1.5

sgl-omni serve \
 --model-path OpenMOSS-Team/MOSS-TTS-Local-Transformer-v1.5 \
 --port 8000
默认布局会把 AR backbone 和 codec/vocoder colocate 到一张 GPU 上。显式配置位于 examples/configs/moss_tts_local.yaml。
server 启动后,一个基础 synthesis request 会返回 WAV 文件:
curl -X POST http://localhost:8000/v1/audio/speech \
 -H "Content-Type: application/json" \
 -d '{"input": "SGLang-Omni is a great project for high-fidelity speech generation."}' \
 --output output.wav
voice cloning、streaming PCM、duration control、pause markup、pronunciation hints、language hints、sampling parameters 和 benchmark commands 见 cookbook。
Roadmap
当前路径已经端到端可用,但仍有几个部分值得继续改进:
Pool-native frame CUDA Graph。 当前 frame-decode graph 使用 persistent state pools,但 sampling parameters 和 generated rows 旁边仍有一些 staging。更原生的 pool-to-pool graph path 可以简化 launch/resolve 边界。
Adaptive streaming scheduling。 Streaming TTS 存在真实的 latency-throughput trade-off。我们正在探索 load-aware chunk sizing、priority-aware slot scheduling 和更好的 coalescing policies,使低负载请求获得更快的 first audio,同时让高负载部署恢复更多 throughput。
Broader compilation coverage。 codec encoder 和 Qwen3 backbone 仍有 targeted compilation experiments 的空间。我们会把 compile scope 控制在足够窄的范围内,避免 cold-start regressions 和输出变化。
Wider benchmark coverage。 当前测量聚焦 CI 中的 SeedTTS English。我们计划扩展到中文、多语言 evaluation、long-form generation、multiple speaker pools、不同 reference lengths,以及更接近生产的 traffic mixes。
加入我们
如果你对 TTS、omni models、streaming inference、CUDA Graphs、scheduling、communication、model onboarding、benchmarking 或 production serving 感兴趣,欢迎加入我们。
致谢
SGLang-Omni - Jiaxin Deng,Haoguang Cai, Shangming Cai, Yuhao Chen, Kangxiang Shao, Hao Jin, Yifei Gao, Jingwen Gu, Zhihao Guo, Chenchen Hong, Xinli Jing, Xiangrui Ke, Estella Liu, Xinyu Lu, Ratish Palanisamy, Mick Qian, Yijiang Tian, Zijie Xia, Xuesong Ye, Yue Yin, Gaokai Zhang, Xiaoyu Zhang, Chenyang Zhao, Yichi Zhang。
MOSS-TTS Local Transformer v1.5 - Yitian Gong, Kuangwei Chen, Zhicheng Zhang, Botian Jiang, Yiyang Zhang, Kang Yu, Yang Gao, Xiaogui Yang, Qinyuan Chen, Zhaoye Fei, Shimin Li, Xipeng Qiu。
了解更多
- Model: OpenMOSS-Team/MOSS-TTS-Local-Transformer-v1.5
- Serving framework: SGLang-Omni on GitHub
- Documentation: SGLang-Omni docs
- MOSS-TTS-Local cookbook: MOSS-TTS-Local in SGLang-Omni
- MOSS optimization roadmap: MOSS TTS Performance Optimization Roadmap (#637)
- Design background: SGLang-Omni: Redesigning the Inference Framework for Multi-Stage Generative Models# 在 SGLang-Omni 上部署原生流式 48 kHz 的 MOSS-TTS Local Transformer v1.5 语音服务
MOSI、OpenMOSS 团队与 SGLang-Omni Team・2026 年 6 月
我们正在发布 MOSS-TTS-Local-Transformer-v1.5 在 SGLang-Omni 上的端到端 serving 支持。这项工作由 SGLang-Omni Team 和 OpenMOSS 团队 共同完成。
MOSS-TTS-Local-Transformer-v1.5 是一个开放的 TTS 模型,支持 48 kHz 立体声、zero-shot voice cloning、长文本合成、多语言生成、时长控制和 native streaming。用 demo script 调起这个模型并不难,真正难的是把它服务好:一个请求会跨过参考音频编码、Qwen3-4B 自回归 backbone、frame-local 的 12-codebook sampling loop,以及有状态的 codec decoder。
SGLang-Omni 没有把 MOSS-TTS-Local-Transformer-v1.5 硬塞进单个 LLM decode loop,而是把它作为三阶段 pipeline 来服务。本文的工作主要围绕这层映射:阶段边界在哪里,哪些部分需要模型专用 hook,以及模型在负载下运行后暴露出了哪些瓶颈。
MOSS-TTS-Local-Transformer-v1.5 模型
MOSS-TTS-Local-Transformer-v1.5 是 MOSS-TTS v1.5 家族的第二个旗舰模型。它沿用了 Audio Tokenizer + LLM autoregressive 路线,使用更重的 audio codec,以及 Global Transformer + Local Transformer 的生成路径。
它支持 direct TTS、continuation、zero-shot voice cloning、时长控制、显式 pause markup 例如 [pause 3.2s],以及最长 10 分钟的 long-form generation。模型覆盖 31 种主要语言,训练数据约为 400 万小时多语言语音。
MOSS-TTS-Local-Transformer-v1.5 model architecture
在音频边界,MOSS 使用 MOSS-Audio-Tokenizer-v2,这是一个 encoder 和 decoder 合计约 2B 参数的 neural audio tokenizer。它以 12.5 Hz 运行,支持 0.125 kbps 到 4 kbps 的可变比特率压缩,重建 48 kHz 立体声音频,并通过 residual vector quantization (RVQ) 表示语音。
生成核心使用 Qwen3-4B backbone。global transformer 按 frame 推进序列。对于每一帧,一层 local transformer 先输出 stop/continue 决策,然后按顺序采样 12 个 RVQ codebook,并在采样下一个 codebook 前把当前采样结果反馈回来。
serving 可见的 token layout 是 [T, 13]:一个 text/control channel 和 12 个 audio codebook channel。text 位置在 channel 0 放 text token,其余 channel 放 audio padding。audio 位置在 channel 0 放 slot/control token,并在每个 audio codebook channel 放一个 RVQ code。这是 MOSS 第一次不再像普通 next-token model 的地方:每个生成的 frame 是一行,而不是一个标量 token。
在公开 model-level evaluation set 上:
表格
| Benchmark | WER(越低越好) | SIM(越高越好) |
|---|---|---|
| Seed-TTS-Eval | 5.10% | 69.23% |
| CV3-Eval | 7.48% | 61.59% |
| MiniMax Multilingual | 6.37% | 75.31% |
| X Voice | 20.48% | 63.00% |
这些是 offline model metrics。后面的 serving benchmark 使用不同的 evaluation pipeline,应当按端到端系统测量来解读。
MOSS-TTS-Local-Transformer-v1.5 在阿里云 PPU-ZW810 集群上以千卡规模训练。本文聚焦 serving 侧。
为什么 MOSS 需要多阶段 serving runtime
标准 LLM serving engine 围绕一个重复执行的 model loop 构建。MOSS 的一个请求中包含三类不同的工作:
- 预处理和参考编码。 文本会被 tokenize,参考音频会被加载,参考 waveform 会被编码成 RVQ codes。
- Autoregressive TTS engine。 Qwen3 backbone 和 local transformer 生成
[1, 13]的 frame rows。 - Streaming vocoder。 生成的 RVQ rows 会被有状态的 MOSS codec decoder 解码为 waveform chunks。
每个阶段的瓶颈都不同。参考编码运行大型 neural codec encoder。AR generation 把普通 backbone decode 和一个很小但严格串行的 local codebook loop 混在一起。vocoder 是有状态 decoder,必须跨 chunks 保留 streaming state。系统需要同时管理这三部分,并避免某个阶段的 batching 或内存行为破坏其他阶段。
用 SGLang-Omni 服务 MOSS
SGLang-Omni 将 MOSS-TTS Local Transformer v1.5 作为三阶段 pipeline 来服务:
preprocessing -> tts_engine -> vocoder
preprocessing 阶段解析 OpenAI-compatible request,准备 multi-channel prompt,并为 voice cloning 编码参考音频。tts_engine 阶段运行在 OmniScheduler 上,因此 MOSS 可以复用 SGLang 的 request batching 和 KV-cache 机制,同时携带模型专用的 [T, 13] rows。vocoder 阶段以 stream 方式消费生成的 rows,并从一个持久化的 codec streaming session 返回 audio chunks。
复用的部分是 runtime 形态:stage lifecycle、scheduler interface、inter-stage routing、streaming outputs、process placement,以及 stage-level resource accounting。MOSS 专用的部分更小也更显式:如何构造 multi-channel prompt,如何运行 frame-local codebook loop,以及如何把 MOSS codec 接成 streaming decoder。下一节只聚焦这些 MOSS 专用瓶颈和优化。
MOSS 端到端优化
pipeline 功能完成后,我们优化了 profiling 中反复出现重复工作或 launch overhead 的阶段。
表格
| Area | Change | Main Benefit | Source |
|---|---|---|---|
| Model serving baseline | MOSS Local model、pipeline 和 API 支持 | 建立三阶段 serving 路径 | PR #728 |
| Reference encoding | batched encoding、content-addressed LRU cache 和 single-flight deduplication | 避免为复用 speaker 重复运行 codec encoder | PR #748PR #778PR #788 |
| AR engine | decode-state pool、frame CUDA Graph support 和 GPU-native row hash | 让 decode state 保持稳定 GPU 地址,并移除每帧 host hashing | PR #745 |
| AR engine | frame launch-state pooling 和 async decode plumbing | 降低 launch 准备开销,并修复 decode-step ownership 问题 | PR #759PR #758 |
| AR engine | compiled seeded sampler | 融合 hot sampling path,同时保持 deterministic per-request sampling | PR #773 |
| Vocoder | stateful streaming session、stream slots 和 coalesced chunk scheduling | 用 request isolation 支持 frame-level audio streaming | PR #753 |
| Vocoder | stateful vocoder CUDA Graph | 加速短 streaming decode steps | PR #798 |
| Cross-stage | explicit colocated memory budgeting | 防止 codec 和 AR 的内存压力互相干扰 | PR #810 |
Source 列为 SGLang-Omni GitHub PR 编号,点击可查看详情。
参考音频编码
voice cloning 经常在很多 prompts 之间复用同一批 speakers。在 MOSS 中这一点很重要,因为参考编码要在 AR generation 开始前运行大型 codec encoder。
Content-addressed reference audio cache
SGLang-Omni 将 batched reference encoding 与 content-addressed LRU cache 结合。重复的 reference 由音频内容而不是路径作为 key,因此复制或重命名后的文件仍然可以复用同一个 encoded RVQ result。single-flight 路径会合并同一个 speaker 的并发 miss,避免冷缓存突发时启动重复的 codec encode。
在 SeedTTS English evaluation 中,在 2x H100、concurrency 16 下,将 reference cache capacity 从 256 提升到 1024 entries,使 throughput 提升 32.0%,mean latency 降低 24.3%。内存成本很小,因为 encoded code tensors 很紧凑;更大的 cache 主要是避免 active speaker working set 被驱逐。
AR Engine
MOSS AR engine 有两层计算:Qwen3 backbone 和 local transformer frame-decode loop。SGLang-Omni 用 CUDA Graphs 捕获两者,但保持分离,因为它们的结构和 ownership 不同。
Eager vs. CUDA Graph execution
backbone graph 使用 SGLang 标准的 CUDA Graph path 进行 causal LM decode。MOSS 专用的 frame graph 捕获一个完整 frame 的 local transformer micro-loop:stop/continue sampling、12 个顺序 codebook projections、codebook feedback,以及为下一帧组装 feedback embedding。它从这个很小但高度串行的 loop 中移除了 launch overhead。
为了让 graph replay 成为可能,MOSS 将 per-request decode state 保存在持久化的 GPU-side pool 中。feedback embeddings、sampling parameters、seeds、counters 和 audio history 跨 frame 保持稳定地址。SGLang-Omni 还把 generated-row radix hash 移到 GPU,避免每帧 CPU hash 和 D2H synchronization。
每帧的 13 次 sampling operation 使用 seeded GPU sampler。我们只 compile 这个 sampling path,不 compile backbone 或 local transformer。在 SeedTTS English、concurrency 16 下,这个窄范围优化在不改变更大模型执行路径的情况下,使 throughput 提升 12.3%,mean latency 降低 11.1%,mean RTF 降低 10.5%。
Streaming Vocoder
vocoder 阶段把生成的 RVQ frames 转换为 audio chunks。由于 MOSS-Audio-Tokenizer-v2 支持 stateful streaming decode,SGLang-Omni 在 vocoder executor 内保留一个持久化的 codec streaming session。
scheduler 管理 stream slots、offline fallback slot、chunk thresholds 和 coalesced decode steps。首个 chunk 可以使用较小 threshold 来降低 time to first audio,后续 chunks 则使用更大的窗口来提高 throughput。当多个请求都有足够的 pending frames 时,scheduler 会把它们合并到一次 codec call 中解码。
短 streaming chunks 对 launch 很敏感,因此 SGLang-Omni 用 CUDA Graphs 捕获常见的 vocoder frame counts。实现中 codec state buffers 保持稳定地址并原地更新,使 graph 可以跨 streaming steps replay。
短 streaming chunks 的加速最明显:
表格
| Frames per Step | Eager | CUDA Graph | Speedup |
|---|---|---|---|
| 4 | 66.3 ms | 30.1 ms | 2.20x |
| 5 | 65.8 ms | 30.7 ms | 2.14x |
| 8 | 65.6 ms | 34.0 ms | 1.93x |
| 13 | 65.4 ms | 40.4 ms | 1.62x |
| 25 | 74.8 ms | 58.3 ms | 1.28x |
| 100 | 222.9 ms | 215.3 ms | 1.04x |
当 frame count 没有被 capture,或内存紧张时,graph path 会 fallback 到 eager decode。streaming/non-streaming consistency checks 覆盖了这条路径。
内存预算
在默认 MOSS Local config 中,preprocessing、AR generation 和 vocoder execution 可以 colocate 到一张 GPU 上。这种紧凑布局很方便,但 AR engine 和 codec runtime 的 allocation pattern 不同。因此 SGLang-Omni 给 AR engine 一个显式的 colocated memory contract,并为 codec runtime allocations 和 streaming state 预留 headroom。
在单卡 colocated 配置、concurrency 8 下,显式 codec memory budgeting 使 throughput 提升 8.9%,mean RTF 降低 8.4%。更重要的是,它让 memory pressure 下的部署行为可预测。
性能
我们在包含 1088 个 samples 的 SeedTTS English set 上评估优化后的 serving path。下面结果来自启用 vocoder CUDA Graph 后的完整 CI evaluation,使用 2x GPU 和 client concurrency 16。ASR scoring 使用 Qwen3-ASR-1.7B,speaker similarity 使用 WavLM-Large finetune。
表格
| Mode | Completed / Failed | Throughput | Audio Throughput | Mean Latency | Mean RTF | WER |
|---|---|---|---|---|---|---|
| Non-streaming | 1088 / 0 | 5.976 req/s | 26.303 audio s/s | 2.669 s | 0.644 | 1.75% |
| Streaming | 1088 / 0 | 2.909 req/s | 12.804 audio s/s | 5.474 s | 1.322 | 2.14% |
non-streaming 达到 5.976 req/s,mean RTF 为 0.644。streaming 会发出增量 audio chunks;在 concurrency 16 下,平均 inter-chunk interval 是 0.109 s,每个请求平均发出 8.82 个 chunks。streaming throughput 更低是预期内的:vocoder 会用更小 chunks 更频繁地运行,并与 AR engine 共享 GPU 时间。
两个模式的质量数字保持接近:同一个 CI run 中,non-streaming WER 是 1.75%,streaming WER 是 2.14%。streaming/non-streaming artifact consistency checks 也通过。
不要把单项优化的测量结果相加成一个 headline number,因为它们是在不同硬件和 concurrency 设置下采集的。它们更适合用作 MOSS 耗时分布图:reference caching 移除冗余 encoder work,frame CUDA Graphs 移除 local-loop launch overhead,sampler compilation 优化 hot sampling path,vocoder CUDA Graphs 加速短 streaming chunks,memory budgeting 稳定 colocated deployment。
自己试用
SGLang-Omni MOSS-TTS-Local cookbook 提供完整 setup、API options 和 streaming examples。最小路径如下:
安装并启动服务
docker pull lmsysorg/sglang-omni:dev
docker run -it --gpus all --shm-size 32g --ipc host --network host --privileged \
 lmsysorg/sglang-omni:dev /bin/zsh

git clone git@github.com:sgl-project/sglang-omni.git
cd sglang-omni
uv venv .venv -p 3.12
source .venv/bin/activate
uv pip install -v -e .

hf download OpenMOSS-Team/MOSS-TTS-Local-Transformer-v1.5

sgl-omni serve \
 --model-path OpenMOSS-Team/MOSS-TTS-Local-Transformer-v1.5 \
 --port 8000
默认布局会把 AR backbone 和 codec/vocoder colocate 到一张 GPU 上。显式配置位于 examples/configs/moss_tts_local.yaml。
server 启动后,一个基础 synthesis request 会返回 WAV 文件:
curl -X POST http://localhost:8000/v1/audio/speech \
 -H "Content-Type: application/json" \
 -d '{"input": "SGLang-Omni is a great project for high-fidelity speech generation."}' \
 --output output.wav
voice cloning、streaming PCM、duration control、pause markup、pronunciation hints、language hints、sampling parameters 和 benchmark commands 见 cookbook。
Roadmap
当前路径已经端到端可用,但仍有几个部分值得继续改进:
Pool-native frame CUDA Graph。 当前 frame-decode graph 使用 persistent state pools,但 sampling parameters 和 generated rows 旁边仍有一些 staging。更原生的 pool-to-pool graph path 可以简化 launch/resolve 边界。
Adaptive streaming scheduling。 Streaming TTS 存在真实的 latency-throughput trade-off。我们正在探索 load-aware chunk sizing、priority-aware slot scheduling 和更好的 coalescing policies,使低负载请求获得更快的 first audio,同时让高负载部署恢复更多 throughput。
Broader compilation coverage。 codec encoder 和 Qwen3 backbone 仍有 targeted compilation experiments 的空间。我们会把 compile scope 控制在足够窄的范围内,避免 cold-start regressions 和输出变化。
Wider benchmark coverage。 当前测量聚焦 CI 中的 SeedTTS English。我们计划扩展到中文、多语言 evaluation、long-form generation、multiple speaker pools、不同 reference lengths,以及更接近生产的 traffic mixes。
加入我们
如果你对 TTS、omni models、streaming inference、CUDA Graphs、scheduling、communication、model onboarding、benchmarking 或 production serving 感兴趣,欢迎加入我们。
致谢
SGLang-Omni - Jiaxin Deng,Haoguang Cai, Shangming Cai, Yuhao Chen, Kangxiang Shao, Hao Jin, Yifei Gao, Jingwen Gu, Zhihao Guo, Chenchen Hong, Xinli Jing, Xiangrui Ke, Estella Liu, Xinyu Lu, Ratish Palanisamy, Mick Qian, Yijiang Tian, Zijie Xia, Xuesong Ye, Yue Yin, Gaokai Zhang, Xiaoyu Zhang, Chenyang Zhao, Yichi Zhang。
MOSS-TTS Local Transformer v1.5 - Yitian Gong, Kuangwei Chen, Zhicheng Zhang, Botian Jiang, Yiyang Zhang, Kang Yu, Yang Gao, Xiaogui Yang, Qinyuan Chen, Zhaoye Fei, Shimin Li, Xipeng Qiu。
了解更多
- Model: OpenMOSS-Team/MOSS-TTS-Local-Transformer-v1.5
- Serving framework: SGLang-Omni on GitHub
- Documentation: SGLang-Omni docs
- MOSS-TTS-Local cookbook: MOSS-TTS-Local in SGLang-Omni
- MOSS optimization roadmap: MOSS TTS Performance Optimization Roadmap (#637)
- Design background: SGLang-Omni: Redesigning the Inference Framework for Multi-Stage Generative Models