模型简介
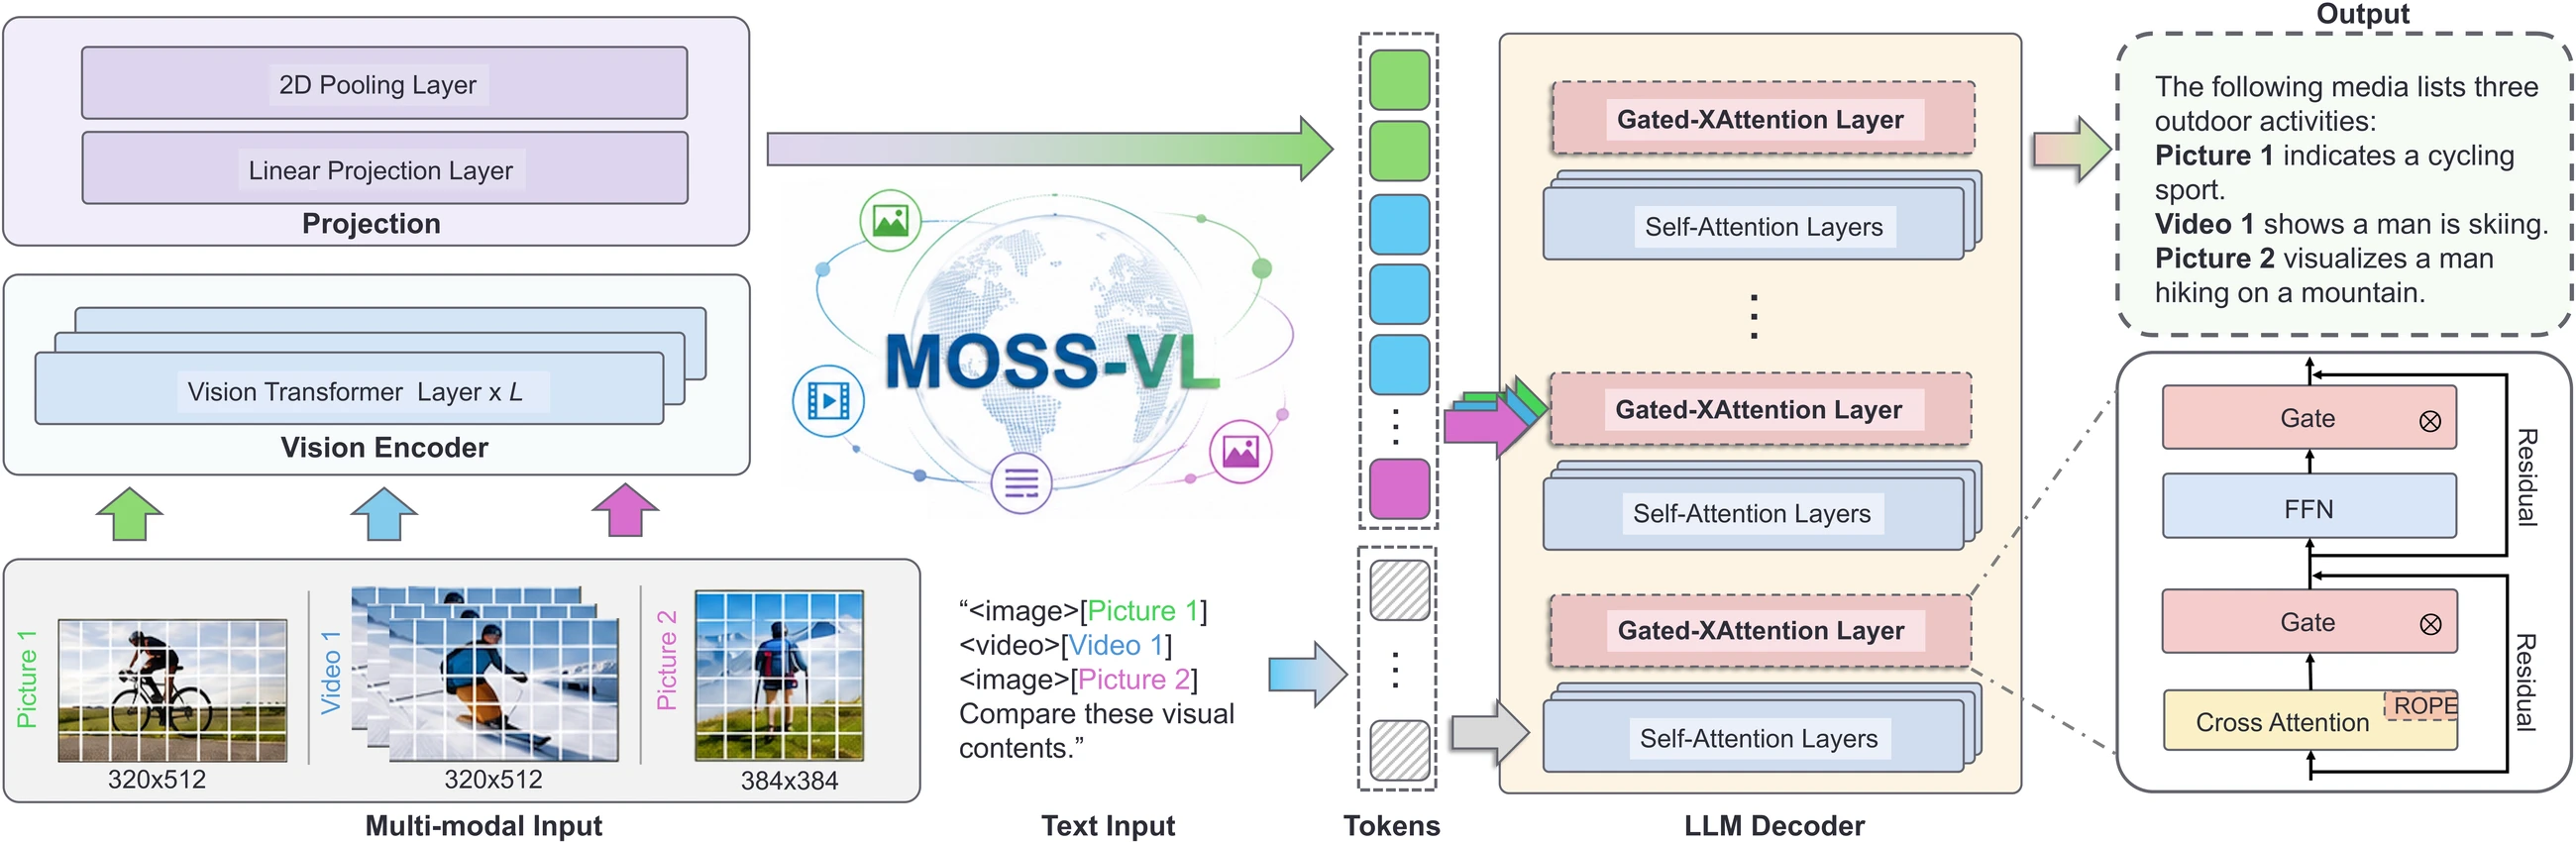
MOSS-VL 是 OpenMOSS 生态系统中核心的多模态模型系列,采用基于交叉注意力(Cross-attention)的架构,实现视觉编码与认知推理的解耦,为离线图像与视频理解提供统一基座。模型原生支持模态交错,可在统一的流水线中处理文本、单图、多图、单视频、多视频以及图文/视频交错输入,无需繁重的预处理流程;持续视频流上的实时交互由同系列的 MOSS-VL-Realtime 提供。
模型总参数量 11.3B:48 层语言解码器初始化自 Qwen3-8B,每四层插入一层门控交叉注意力层(Gated X-Attention);27 层视觉编码器以原生动态分辨率(4K–16.8M 像素)处理图像与视频帧;上下文长度达 256K tokens。通过为每一采样帧注入绝对时间戳,并采用专为交叉注意力通道设计的 XRoPE 位置编码,MOSS-VL 将文本与视频帧映射到统一的 (t, h, w) 三维时空坐标系,把推理过程锚定在精确的时间基准之上,从而精准感知事件的节奏与时长。
MOSS-VL 通过数据、参数、上下文三个维度的系统性扩展(Scaling)构建能力,四阶段预训练与指令微调共消耗约 1.37 万亿 tokens,支持中英文双语。本代交付三个同源模型——MOSS-VL-Instruct 承接离线对话与下游任务、MOSS-VL-Base 供继续预训练与微调、MOSS-VL-Realtime 面向实时交互,与前代 0408 两个模型共五个 checkpoint,全部以 Apache-2.0 协议开源。
功能描述
-
视频理解: 绝对时间戳使模型原生适配可变帧率,支持细粒度动作定位、跨时段事件关联与速度、轨迹等运动分析;在 Minerva(40.5)、TOMATO(39.5)、VideoMME-Logical(17.1)等时序推理基准上领先同规模开源模型 4.9 分以上,EgoSchema 达 67.0,并覆盖 MLVU、LongVideoBench、LVBench 等长视频理解基准。
-
多模态感知: 原生动态分辨率下实现细粒度物体识别与空间推理,感知为最强能力域——MMBench-EN 88.1、POPE 89.4、V*Bench 89.0 均列同规模第一,MME-RealWorld(66.3)与 BLINK(78.0)以 8.9 分优势领先。
-
图像关键信息提取与多图推理: 识别图像中的文字内容(OCR),推理多图之间的逻辑联系与对比关系,支持单图、多图与图文交错输入。
-
文档布局解析: 将论文、报告等文档转化为 Markdown 格式,完成版面结构识别与信息提取;OmniDocBench 达 88.9,领先次优 4.0 分,DocVQA 89.6、ChartQA 87.8、OCRBench 86.1。
-
视觉定位(Grounding): 支持指代表达定位与时空 Grounding,在对抗性定位基准 Ref-Adv 上以 57.0 分领先次优 7.7 分。
-
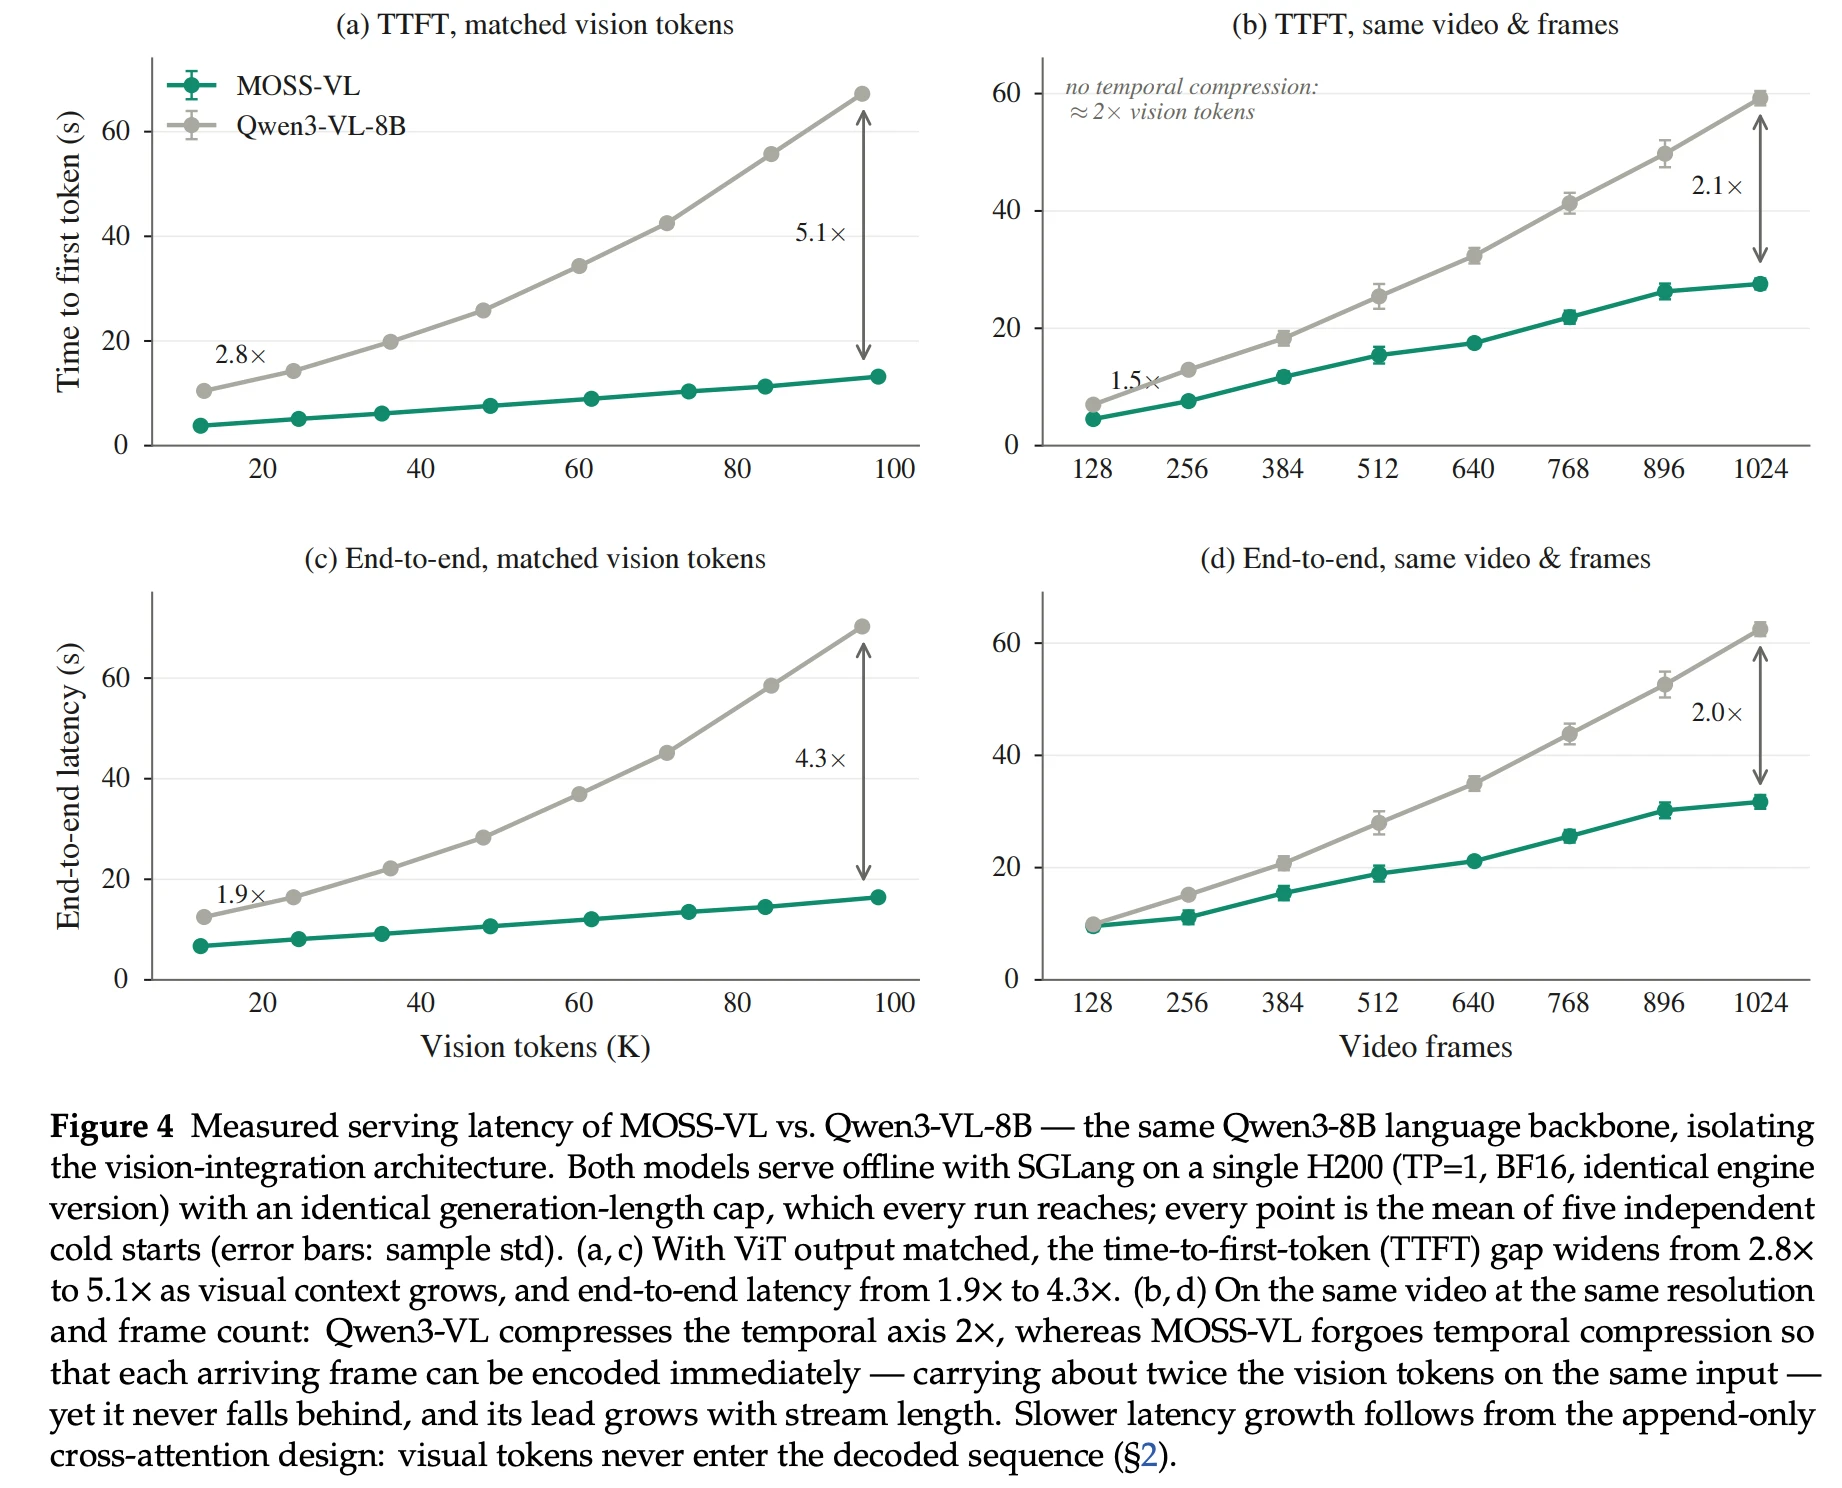
高效推理与部署: 视觉 token 不进入解码序列,服务延迟随视觉上下文增长更缓——单卡 H200 上首 token 延迟较同语言主干的 Qwen3-VL-8B 快 2.8–5.1 倍;SGLang 已官方支持,并提供 FP8/NF4 量化权重(单卡 24GB 显存即可推理)以及 LlamaFactory、ms-swift 开箱即用的微调支持。
Benchmark
离线评测:MOSS-VL-Instruct 与同规模开源模型对比(加粗为该基准最优,"–" 为官方未报告):
| 能力域 | 基准 | MOSS-VL | Qwen3-VL-8B | Qwen2.5-VL-7B | LLaVA-OneVision-2-8B | Gemma-4-12B-IT |
|---|---|---|---|---|---|---|
| 多模态感知 | MMBench-EN | 88.1 | 84.8 | 83.2 | 85.8 | 82.7 |
| 多模态感知 | MMStar | 66 | 70.9 | 63.9 | 64.8 | 74.9 |
| 多模态感知 | MME-RealWorld | 66.3 | – | 57.4 | – | 46.9 |
| 多模态感知 | BLINK | 78 | 69.1 | 56.4 | 63.5 | 65.6 |
| 多模态感知 | POPE | 89.4 | – | 87.4 | – | 81.4 |
| 多模态感知 | MMMU (val) | 51.1 | 69.6 | 58.6 | – | 69.7 |
| 多模态感知 | V*Bench | 89 | 85.3 | – | 85.9 | 51.8 |
| 视频理解 | VideoMME | 68.1 | 71.4 | 65.1 | 71.9 | 60.5 |
| 视频理解 | MLVU (dev) | 76.8 | 78.1 | 70.2 | 76.6 | – |
| 视频理解 | LongVideoBench | 65.9 | 68 | 56 | 66.9 | 58.2 |
| 视频理解 | LVBench | 51.1 | 58 | 45.3 | 55.5 | 37.3 |
| 视频理解 | EgoSchema | 67 | – | 65 | – | 62.2 |
| 视频理解 | VSI-Bench | 62.2 | 59.4 | 28.3 | 70.9 | 25.9 |
| 视频理解 | Minerva | 40.5 | – | – | – | 32.3 |
| 视频理解 | TOMATO | 39.5 | 34.6 | – | – | 31.9 |
| 视频理解 | VideoMME-Logical | 17.1 | 11.9 | 7.4 | – | 10.8 |
| 视觉定位 | RefCOCO-REC | 84.4 | 91.6 | 90 | – | – |
| 视觉定位 | Ref-Adv | 57 | 47.2 | 49.3 | – | – |
| 文档/OCR | DocVQA (val) | 89.6 | 96.1 | 95.7 | 95.2 | 80.8 |
| 文档/OCR | ChartQA | 87.8 | 89.6 | 87.3 | 85.9 | 51.2 |
| 文档/OCR | OCRBench | 86.1 | 89.6 | 86.4 | 78.2 | 76.9 |
| 文档/OCR | OmniDocBench | 88.9 | 84.9 | – | – | – |
| 推理 | VisuLogic | 27.5 | 22.5 | 26 | – | – |
| 推理 | ERQA | 45.8 | 45.8 | – | 43.3 | 40.8 |
注:MOSS-VL 评测采用 1 fps 采样、最多 768 帧;基线数据取自各官方报告。完整 39 项基准见技术报告 Table 5。

推理效率: 在单卡 H200、SGLang 部署、相同生成长度上限的实测条件下,MOSS-VL 相对同语言主干 Qwen3-VL-8B 的首 token 延迟(TTFT)优势随视觉上下文增长从 2.8× 扩大至 5.1×,端到端延迟优势从 1.9× 扩大至 4.3×;在相同视频输入下,MOSS-VL 因不做时序压缩而携带约两倍视觉 token,仍未在任何测点落后。
Demo
模型下载
| 模型 | 参数量 | 上下文 | 适用场景 | Hugging Face | ModelScope |
|---|---|---|---|---|---|
| MOSS-VL-Instruct-0708 | 11B | 256K | 离线对话/推理/下游任务 | Hugging Face | ModelScope |
| MOSS-VL-Base-0708 | 11B | 256K | 继续预训练/微调 | Hugging Face | ModelScope |
| MOSS-VL-Realtime | 11B | 256K | 持续视频流实时交互 | Hugging Face | ModelScope |
| MOSS-VL-Instruct-0408 | 11B | 256K | 对话/推理/下游任务 | Hugging Face | ModelScope |
| MOSS-VL-Base-0408 | 11B | 256K | 继续预训练/微调 | Hugging Face | ModelScope |