今天的AI,已经能够读懂文字、识别图片、理解声音,甚至生成连贯的视频。但当模型同时拥有语言、视觉和听觉能力,它是否就真正理解了这个世界?
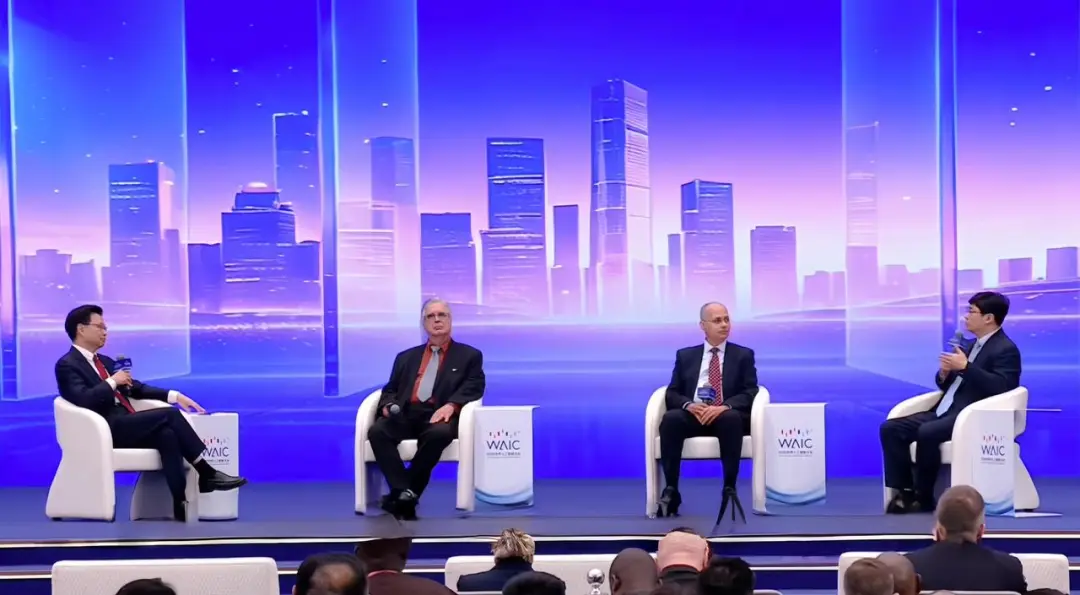
复旦大学教授、OpenMOSS项目负责人、模思智能首席科学家邱锡鹏教授在7月17日世界人工智能大会主论坛中与 2025年诺贝尔化学奖得主 Omar M. Yaghi、2025年图灵奖得主及量子信息技术先驱 Gilles Brassard,以及中国科学院院士鄂维南同台讨论。
邱锡鹏教授围绕多模态、真实世界理解以及下一代AI范式,分享了自己的判断。在他看来,未来AI的发展重点,并不只是继续增加图像、视频和声音等模态,也不只是不断扩大模型的上下文窗口。更关键的问题是:
AI能否理解人在特定场合下所表达的意思,以及周围复杂环境所构成的真实情境。
这指向的,是一种从“处理信息”走向“理解情境”的能力。
语言仍然是智能理解世界的重要基础
关于下一代AI,学术界和产业界存在两种不同观点。
一种观点认为,语言模型仍然会是未来AI的核心。图像、声音和视频等不同模态,都可以转化为模型能够处理的统一表征,最终由语言模型完成理解、推理和生成。
另一种观点则认为,当AI从数字空间走向物理空间,进入机器人、世界模型等场景后,多模态将不再是语言模型的简单延伸,而会成为智能系统内生的一部分。
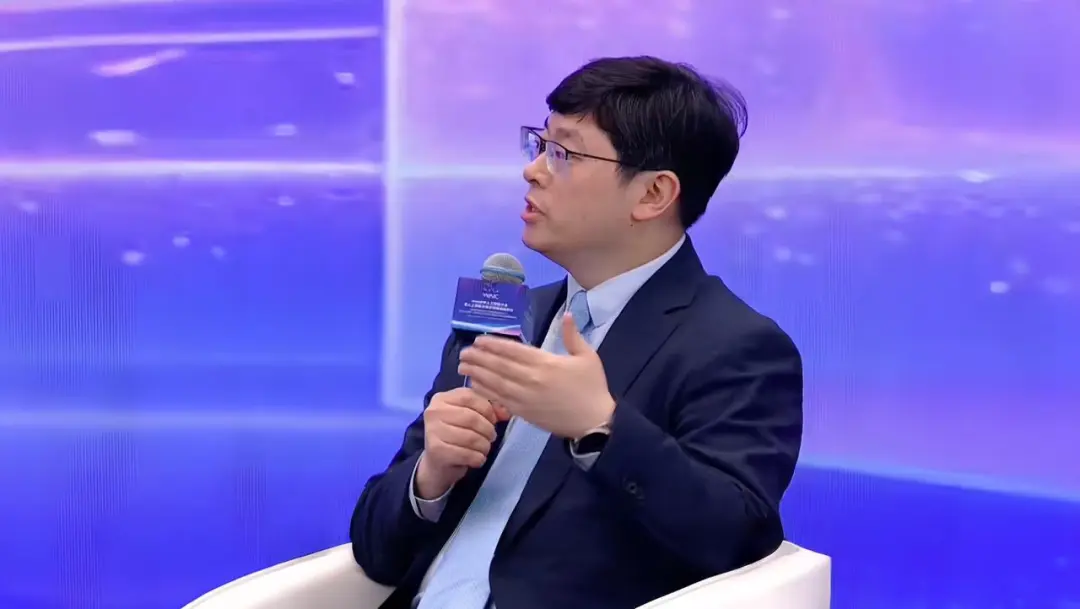
面对这两条路线,邱锡鹏教授认为,智能仍然需要依赖语言,语言是人类认知和理解世界的重要渠道。
人类对世界的认知、描述和知识组织,很大程度上都依赖语言。语言不仅是一种沟通工具,也是人类构建抽象概念、表达复杂关系的重要方式。但这并不意味着,只要把图片、声音和视频转化成语言,问题就已经解决。多模态真正的挑战,是如何将不同来源的信息与语言进行有效对齐,让模型不仅能够识别单个信息,还能够理解这些信息之间的关系。一张图片中出现了什么,一段音频里说了什么,一段视频中发生了什么,只是理解世界的第一步。模型还需要进一步判断:
这些事情为什么会发生?
不同信息之间有什么联系?
它们共同构成了一个怎样的现实状态?
多模态的价值,不在于让模型拥有更多输入通道,而在于让模型形成更加完整的世界认知。
AI需要理解的Context,不只是聊天窗口
过去几年,大模型不断刷新上下文长度。从几千Token到数十万、数百万Token,模型一次能够读取和处理的信息越来越多。但邱锡鹏教授所强调的Context,并不只是上下文有多长,也不只是打开的窗口有多大。它指向的是现实世界中更加复杂的“情境”。
例如,当机器人进入一个真实空间与人交流时,它面对的并不是一段已经整理好的文字。它需要同时处理:
说话者表达了什么;
说话时采用了怎样的语气;
对话发生在什么场合;
周围有哪些人和物体;
人物之间是什么关系;
此前发生过什么;
接下来可能发生什么。
同一句“没关系”,可能是在安慰别人,也可能是在掩饰失望。同一句“你先回去吧”,放在工作、家庭或亲密关系中,可能具有完全不同的含义。人类往往能够根据语气、表情、环境和关系快速理解这些差异,但对于当前的模型而言,这仍然是一项困难的任务。**邱锡鹏教授指出,现阶段模型对于世界的理解还远远不够。**模型可能已经能够识别一个人、一个物体或一句话,却不一定能够理解人在特定场合下真正想表达的意思,也难以完整把握周围复杂环境对交流产生的影响。
因此,下一代AI需要的并不只是更长的文本记忆,而是对现实情境更完整的建模能力。对Context的讨论不能只停留在文本窗口长度,还需要进一步延伸到对现实复杂情境的理解。
下一代AI,可能由AI参与设计
当讨论转向未来五年的人工智能发展时,邱锡鹏教授首先强调,预测技术未来是一件非常困难的事情。
回望过去几年,今天许多看似自然发生的技术变化,在当时并没有被准确预见。一些方向可能曾被高估,一些真正产生深远影响的变化,则可能长期被低估。技术突破也未必会沿着人们预先设定好的路线发生。有时,人们刻意追求的目标未必能够按照预期实现;而一些今天看起来并不受关注的技术,反而可能在持续积累后获得新的发展机会。
在多种可能的未来中,邱锡鹏教授提出了一个值得关注的方向:
AI for AI,我们下一代的AI可能就是由AI来设计的。
随着coding model和agent model取得进展,邱锡鹏教授认为,可以先将这些能力进一步发展,再尝试让AI参与未来多模态模型的设计,探索是否存在更好的模型形态和技术范式。这并不意味着下一代模型已经能够由AI自主完成研发,而是提供了一种新的可能:AI不仅可以应用于其他任务,也可能逐步参与人工智能自身的研究与设计。
真正的范式变化,往往不是突然发生的
邱锡鹏教授提到:“23年的时候,大家看起来GPT是一个很大的范式革新,但它也是一点点走出来的。”
在ChatGPT之前,序列到序列、序列生成以及统一自然语言处理任务等思路,已经经历了长期探索。研究者首先认识到一种技术路线的潜力,随后不断优化模型结构、训练方法、数据和工程体系。直到某一个节点,模型能力跨过临界点,一种新的交互方式和产品形态才真正显现出来。
因此,未来的多模态智能也未必需要完全推翻今天的大模型体系。它可能基于现有的语言模型、coding model和agent model,在真实使用需求的推动下一点点发展,而不一定需要彻底推翻已有体系。一个新范式,往往不是被一次性设计出来的。 它更可能是在持续使用、不断反馈和长期迭代中逐渐生长出来。
从理解语言,到理解正在发生的世界
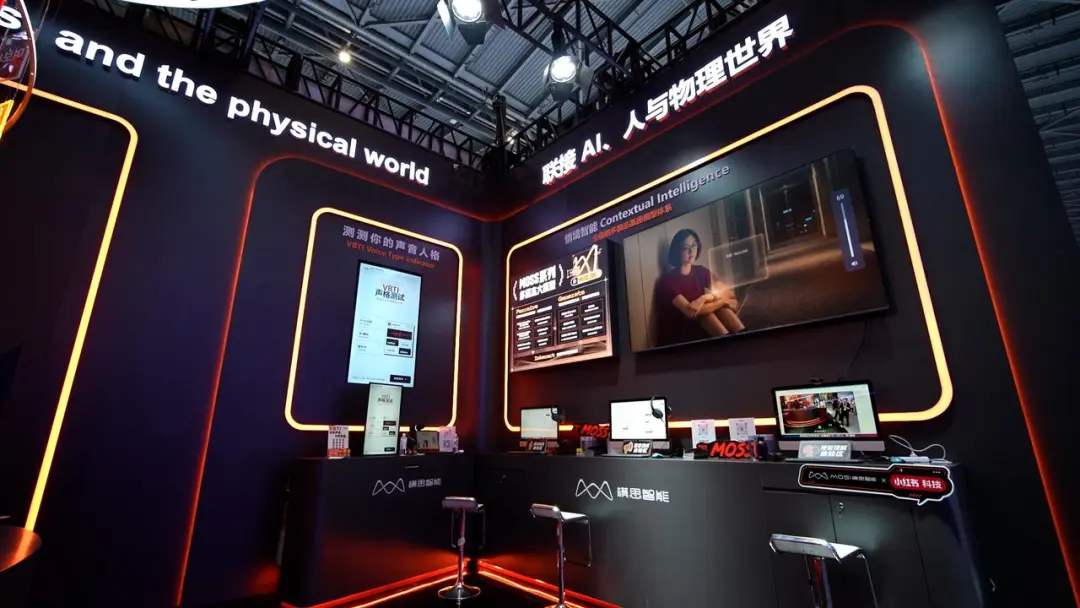
回到模思智能的技术实践,这些讨论也为“情境智能”提供了一个观察视角。
传统AI产品接收到的,往往是一条已经明确表达的指令。用户输入问题,模型生成回答。
但当AI真正进入会议、直播、教育、内容创作和实时交互场景后,它面对的不再是一个静态的问题,而是一段持续发生的过程。多个人可能同时说话,画面中的主体会不断移动,用户的情绪可能发生变化......
真正关键的信息,可能在一段长内容中短暂出现,模型也需要判断,什么时候应该回答,什么时候应该继续观察。
以声音为例,人类表达的信息从来不只存在于文字内容中。说话人的身份、语速、节奏、停顿、音色和情绪,同样构成了交流的重要部分。同一句话由不同的人说出,在不同关系和不同环境中,可能传递完全不同的意图。因此,真正自然的声音智能,不只是让AI能够生成逼真的声音。它还需要理解:
谁正在说话;
说话者处在什么情绪中;
这句话发生在怎样的关系和场景里;
此时应该以怎样的语气作出回应。
围绕这一方向,模思智能持续推进MOSS系列多模态模型研发,覆盖视觉理解、音频理解、语音生成和实时交互等能力。MOSS-VL-Realtime面向持续输入的视频流进行实时理解。在关键信息尚未出现时,模型可以继续观察,而不是急于得出结论。MOSS-Transcribe-Diarize则面向会议、访谈和播客等多人长音频场景,在一个模型中同时处理语音内容、说话人和时间信息。
这些能力并不是将多个模型简单组合在一起。它们共同指向一个目标:
让AI沿着连续的时间轴,理解声音、画面、人物和环境之间不断变化的关系。